Przejdź do treści
Wydział Wiertnictwa, Nafty i Gazu AGHPolski model językowy trenowany od zera
stan z 11.11.2026
Model językowy · Inżynieria wiertnicza · Solvery · Rozeznanie skalowania i runbook

Stanisław: od 1B do 11B

Pierwszy polski model inżynierski zintegrowany z solverami, trenowany od zera i nazwany na cześć prof. Stanisława Stryczka z Wydziału Wiertnictwa, Nafty i Gazu AGH. W zakładkach: patron, bieg 3B na żywo, prognoza dla rozmiarów od 1B do 11B parametrów, solvery oraz instrukcja odtworzenia Stanisława od zera krok po kroku, dla człowieka bez asystenta AI.

Zrobione1B (41 h)
W treningu3B, koniec ~19.11
Sprzęt8 × Blackwell 96 GB
Korpus PL po deduplikacji~175 mld tokenów
Katalog obliczeń do solverów240 (203 po bramce)
Patron

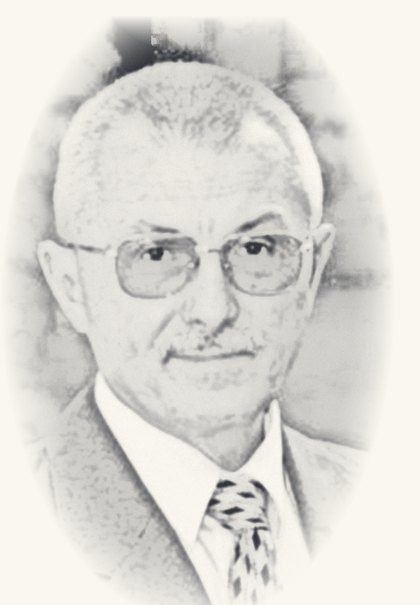
Prof. dr hab. inż. Stanisław Antoni Stryczek (1946–2024)

Portret prof. Stanisława Stryczka, szkic ołówkiem
Szkic ołówkiem wykonany na podstawie fotografii z serwisu Historia AGH.
Stanisław Antoni Stryczek
ur. 10 października 1946 r. w Zakopanem, zm. 6 lutego 2024 r. w Krakowie
Wybitny specjalista z zakresu wiertnictwa i geoinżynierii. Twórca polskiej szkoły zaczynów cementowych i prac iniekcyjnych.SITPNiG, pożegnanie, 8 lutego 2024 r.

Absolwent Wydziału Wiertniczo-Naftowego AGH (1970, mgr inż. górnik, specjalność wiertnictwo). Doktorat w 1974 r. na podstawie pracy „Filtracja zaczynów cementowych w warunkach wysokich ciśnień i temperatur”, habilitacja w 1994 r., tytuł profesora w 2001 r.

Prodziekan ds. nauki (1999–2002), a następnie przez dwie kadencje dziekan Wydziału Wiertnictwa, Nafty i Gazu (2002–2008). Kierował Zakładem, a potem Katedrą Wiertnictwa i Geoinżynierii, sześciokrotnie zasiadał w Senacie AGH. Wieloletni redaktor kwartalnika „AGH Drilling, Oil, Gas”.

Autor ponad 430 publikacji, kilkunastu książek, skryptów i monografii oraz kilkudziesięciu patentów; promotor doktoratów i kilkuset prac dyplomowych. Odznaczony m.in. Krzyżem Kawalerskim i Krzyżem Oficerskim Orderu Odrodzenia Polski oraz Medalem Komisji Edukacji Narodowej. Członek Komitetu Górnictwa PAN i Akademii Inżynierskiej w Polsce, doradca przy akcji ratowniczej w Kopalni Soli „Wieliczka”.

Według wspomnienia Andrzeja Goneta i Jana Ziai do ostatnich dni pracował nad nowymi recepturami zaczynów uszczelniających, by uratować kolejną kopalnię przed zalaniem.

Liczby różnią się między źródłami: wspomnienie w NBI i serwis Inżynieria.com podają 61 patentów i osiem wypromowanych doktorów, Historia AGH 35 patentów i sześć doktoratów; tam też okres kierowania Katedrą to 2008–2014, we wspomnieniu 2008–2012. Dlatego w tekście bez liczb spornych.

Kim jest Stanisław

Jestem Stanisław, pierwszy polski model inżynierski zintegrowany z solverami, nazwany na cześć prof. Stanisława Stryczka, naukowca z Wydziału Wiertnictwa, Nafty i Gazu AGH. Liczby liczą u mnie deterministyczne solvery, wiedzę biorę z dokumentów, a sam pilnuję, żeby wynik był dobrze użyty i uczciwie opisany.

Tak model ma odpowiadać na pytania „kim jesteś”. Zestaw uczący tożsamości i krótki dokument o patronie do bazy wiedzy wejdą w najbliższe strojenie (repozytorium kod/generator_tozsamosc.py); fakty o Profesorze model ma brać z dokumentu, nie z pamięci wag.

Na żywo · zen5

Stanisław 3B w treningu

wczytywanieDane odświeżane co minutę; zen5 wysyła stan co 2 minuty.
–
start 10.11 · rozgrzewka do kroku 2000wyżarzanie od kroku 51 300 →57 000

–

Tempo
–
Łącznie na 8 kartach; partia globalna 1,05 mln tokenów na krok.
Koniec (szacunek czujki)
–
Z tempa ostatnich kroków.
Ostatnia walidacja
–
bpb na odłożonej części mieszanki 3B, co 1000 kroków; niżej = lepiej.
Czujka
–
Pilnuje procesu, straty i walidacji; sama wznawia bieg z ostatniego sprawdzonego checkpointu.

Walidacja w trakcie biegu

Obciążenie kart Blackwell

Osiem kart RTX PRO 6000 Blackwell 96 GB. Karty 0, 1, 6, 7 mają limit mocy 475 W, karty 2–5 to wersje 300 W. Moc i temperatura to odczyt chwilowy, przy zapisie checkpointu (co 200 kroków) spadają na kilkanaście sekund.

–

Część I · Zakres i założenia

Co jest pomiarem, a co szacunkiem

Dokument zestawia dwa rodzaje liczb. Wartości dla 1B i 3B zostały zmierzone na serwerze zen5 (8 × RTX PRO 6000 Blackwell 96 GB, PCIe bez NVLink). Wartości dla 5B, 7B, 9B i 11B są szacunkiem wyprowadzonym z reguły przepustowości dopasowanej do tych dwóch pomiarów oraz z prawa skalowania. Każda liczba szacunkowa jest w tekście oznaczona znakiem „~” lub słowem „szacunek”.

Zastrzeżenie metodyczne. Prognoza jakości pochodzi z prawa skalowania Chinchilli (Hoffmann i in. 2022) w postaci L = E + A/N0,34 + B/D0,28, dopasowanego do korpusów angielskich. Dla polszczyzny i dla tokenizera o innej gęstości informacji wskazuje ono kierunek i rząd wielkości, nie jest prognozą punktową. Procenty w tabeli to względna zmiana redukowalnej części straty (L − E) przy założeniu D = 20N tokenów, odniesiona do modelu 1B.
Podstawa pomiarowa

Zmierzone na zen5

Stanisław 1B · zrobione
1,198 mld wag
22 warstwy, d = 2048. Pretrening ~28 mld tokenów PL w 41 h na 8 kartach, ~23,7 tys. tok/s na kartę. Kontekst rozszerzony do 8k: test „hasło w stogu siana” 97,5% na 4k i 8k, bez regresji na 2k.
Stanisław 3B · w treningu
3,045 mld wag
d = 3072, 26 warstw, 24 głowy, SwiGLU 8192, RoPE 500k, kontekst 2048. Na 8 kartach zmierzone ~77,6 tys. tok/s (~9,7 tys. na kartę; wcześniejszy szacunek 66-68 tys.). Start 10.11, 60 mld tokenów ≈ 9 dni, koniec ok. 19.11. Walidacja bpb: 1,257 (krok 1000) → 0,844 (krok 6000).
Reguła przepustowości
≈ 28 / N tys. tok/s na kartę
N w miliardach parametrów. Pomiary 1B i 3B są z nią zgodne. Dla ≥ 5B doliczono ~30% narzutu na komunikację FSDP przez PCIe (szacunek, nie pomiar).
ZeRO-1 · test
34,8 vs 35,6 tys. tok/s
Bez zysku przepustowości na 4 kartach, ale oszczędza pamięć. Istotne jako krok pośredni przed pełnym FSDP.
Korpus polski
~175 mld unikalnych tokenów
Po deduplikacji; mniej po odkażeniu względem zbiorów testowych. To twardy limit danych dla całego programu skalowania.
Zestawienie

Koszt i przewidywany zysk według rozmiaru

Tokeny wg reguły ≈ 20 na parametr (Chinchilla). Czas dla 1B zmierzony, dla 3B z tempa zmierzonego w trwającym biegu na 8 kartach, dla 5B-11B szacunek z reguły przepustowości z narzutem FSDP. Kolumna „Redukowalna strata” to zmiana L − E względem 1B.

ModelTokeny (≈ 20/param.)Czas na 8 kartachL − E przy D = 20NRedukowalna strata vs 1BW obecnym kodzie?
1B28 mld41 h (zrobione)0,821100%tak
3B60 mld~9 dni (w treningu, tempo zmierzone)0,636−23%tak (82 GB/kartę)
5B100 mld~4 tyg.0,547−33%nie - potrzeba FSDP + checkpointing aktywacji
7B140 mld~2,5 mies.0,494−40%nie
9B180 mld~4 mies.0,457−44%nie
11B220 mld~6 mies.0,431−48%nie

Czas treningu a redukowalna strata

Dwa panele o wspólnej kolejności wierszy i osobnych skalach liniowych. Długość słupków czasu wyrażono w dniach (dla etykiet w tygodniach i miesiącach przyjęto 7 dni i 30 dni), etykiety zachowują wartości z tabeli. Prawy panel to wartość L − E z wzoru Chinchilli; niżej oznacza lepiej.

czas treningu na 8 kartachredukowalna strata L − E

Odczyt: krzywa straty spłaszcza się, a słupki czasu rosną liniowo z liczbą parametrów i tokenów. Między 1B a 3B zysk 23% kosztuje ~5× więcej czasu; między 3B a 7B kolejne 17 punktów kosztuje ~7× więcej.

Prognoza

Czego się spodziewać

1B → 3B: największy skok na jednostkę pracy

Testy wiedzy (polish_mc, ARC) powinny wyjść ponad poziom losowy. Trudne odmowy w RAG, na których 1B utknął na ~0,65, oraz rozumowanie wieloetapowe powinny pójść w górę. Obsługa narzędzi już na 1B wynosi 0,96-1,00 i tu nie ma wiele do zyskania.

Argument za 3B z pomiarów 1B (11.11): cztery strojenia 1B (SFT9, SFT8, SFT10, SFT10a) leżą na jednej krzywej wymiany. Im częściej model trafnie odmawia w trudnych przypadkach (0,535 → 0,859), tym częściej odmawia też tam, gdzie odpowiedź jest w dokumentach (0,048 → 0,186). Różnice dotyczą progu, nie umiejętności rozróżniania: SFT10a odrzuca 107 pytań z odpowiedzią, których SFT8 nie odrzuca, w drugą stronę jest jedno. Do rozróżniania potrzeba większej pojemności albo lepszych danych, nie innych proporcji (szczegóły: etap 9).

3B → 7B: dalsza poprawa, ale ~7× droższa

Przewidywany zysk to mniej niż połowa poprzedniego skoku, przy około siedmiokrotnie większym koszcie czasu. To obszar, w którym rachunek czas/zysk zaczyna przegrywać z barierami z sekcji poniżej.

Uczciwie wobec Bielika 11B

Bielik 11B to Mistral dotrenowany na polskim; odziedziczył wiedzę z bilionów tokenów angielskiego pretreningu. Model od zera na ~175 mld tokenów polskich nawet przy 7-11B nie dogoni go w wiedzy ogólnej. Pole konkurencji to polszczyzna, terminologia, domena i zachowanie (narzędzia, RAG).

Poprawka z 11.11. Wcześniejsza wersja tej strony porównywała Stanisława tylko z Bielikiem w wersji Instruct i pokazywała przewagę 1B na PolEvalu. Bazowy Bielik-11B-v2, zmierzony tą samą metodą 10.11, jest wyraźnie lepszy od 1B w modelowaniu języka: o ~0,10 bpb na PolEvalu i ~0,07-0,11 bpb na domenie. To on jest poprzeczką dla 3B. Różnica między wersjami Bielika najpewniej wynika z tego, że strojenie do poleceń pogarsza bpb.
Test (czysty podzbiór)Stanisław 1BBielik 11B bazowyBielik 11B InstructOdczyt
PolEval, bpb (niżej = lepiej)0,924 (8k) · 0,929 (2k)0,8300,940bazowy Bielik lepszy o ~0,10 bpb; Instruct nieco gorszy od 1B
Domena, bpb (niżej = lepiej)0,686 (8k) · 0,723 (2k)0,6160,679Bielik lepszy w obu wersjach
Terminologia, 86 par (wyżej = lepiej)0,907nie mierzono0,8721B lepszy od wersji Instruct; przedział ~±6-11 pp

„Czysty” = dokumenty bez wspólnych 13-gramów z danymi Stanisława (PolEval n = 1082; domena: skażenie poniżej 10%). Czystość liczona względem danych Stanisława nie mówi, czy Bielik widział te teksty. Bielik liczony na V100 w fp16, kod/ewal_czysty.py.

Bariery

Problemy według skali

Kolejność odpowiada rosnącemu rozmiarowi modelu, od którego dany problem staje się wiążący.

  1. Dane: bariera numer jedenkażda skala

    ~175 mld unikalnych tokenów polskich. Do 9B przy 20 tokenach na parametr wystarcza; przy 11B (220 mld) konieczne powtórki. Do ~4 epok prawie bez straty (Muennighoff i in. 2023), dalej zysk z powtórek gaśnie. Więcej danych oznacza sięgnięcie po niższe biny jakości HPLT lub inne korpusy, kosztem jakości.

  2. Pamięćod 5B

    Obecny trener trzyma pełne wagi fp32 i stan AdamW na każdej karcie, czyli 16 B na parametr: dla 5B to 80 GB przed aktywacjami, na granicy 96 GB. Potrzebny FSDP z pełnym shardingiem i checkpointing aktywacji. Szacowany nakład: około 1 dzień pracy plus testy.

  3. Stabilność treninguod 7B

    Spodziewane skoki straty. Środki zaradcze: QK-norm, z-loss, dłuższy warmup, niższa szybkość uczenia; GQA dla tańszej inferencji. Każdą zmianę architektury wprowadzić i przetestować najpierw na 1B, dopiero potem przenosić wyżej.

  4. Dysk i checkpointyod 5B

    16 B na parametr: 5B to 80 GB, 11B to 176 GB na jeden checkpoint; przy zapisie przez plik tymczasowy chwilowo ×2. Dziś na dysku roboczym wolne ~616 GB, co dla 11B ogranicza liczbę trzymanych checkpointów do kilku.

  5. Czas na cudzej maszynieod 7B

    Serwer należy do zaprzyjaźnionego operatora. Bieg dłuższy niż miesiąc to ryzyko przerw niezależnych od nas. Wznawianie z checkpointu jest gotowe; kalendarz dostępności maszyny to sprawa ludzka, nie techniczna.

  6. Inferencja na atari (Tesla V100)od 11B

    3B i 7B w fp16 mieszczą się na jednej karcie. 11B w fp16 (22 GB) też, ale działa wolniej. Kwantyzacja NVFP4 na ninfer (jak w Superwiertniku) rozwiązuje problem rozmiaru i szybkości.

Wniosek

Rekomendacja

Krok 1
Dokończyć 3B (w treningu od 10.11, koniec ok. 19.11) i ocenić na czystych, nieskażonych testach, z bazowym Bielikiem jako poprzeczką. To jedyny rozmiar, który łączy duży przewidywany zysk z gotowym kodem.
Równolegle
Solvery i strojenie 3B pod asystenta inżyniera: katalog obliczeń z podręczników, silnik w Ruście, dane do strojenia z solvera (sekcja niżej). Strojenie 3B dopiero po końcu treningu podstawowego.
Krok 2
Jeśli skok 1B → 3B potwierdzi prognozę: 5B (~4 tyg.), po wdrożeniu FSDP z checkpointingiem aktywacji i QK-norm przetestowanych wcześniej na 1B.
7B i wyżej
Ma sens dopiero przy większej mocy obliczeniowej lub innej strategii (dane, architektura, podział pracy). Limitem są dane i czas, bardziej niż sam rozmiar modelu.
Kierunek od 11.11

Solvery jako organy modelu

Cel ustalony 11.11: Stanisław ma być przede wszystkim asystentem inżyniera przy realnym projekcie otworu; zadania egzaminacyjne są drugim wyznacznikiem, a model będzie sprawdzany przez naukowców Wydziału. Zasada: rachunek robi deterministyczny solver, wiedzę model bierze z dokumentów, a w wagach zostaje odruch sięgania po narzędzie, wyczucie rzędu wielkości wyniku i dopytywanie o brakujące dane.

Dziś w modelu 1B
5 narzędzi
Hydrostatyka, strata ciśnienia w rurze, dopasowanie reologii, metoda minimalnej krzywizny, geometria trajektorii HDD. Wybór narzędzia 1,000, poprawny wynik 0,96-1,00; najsłabsza trajektoria (pięć parametrów).
Katalog obliczeń
240 obliczeń, 203 po bramce
Dziewięć dziedzin wierceń głębokich z 67 podręczników (m.in. Bourgoyne i in. „Applied Drilling Engineering”, Mitchell i Miska, Nelson, IWCF, Szostak). Bramka: wzór wchodzi, gdy odtwarza przykład z podręcznika co do cyfry. Plus 87 przeliczeń jednostek i 63 stałe polowe wyprowadzone z definicji.
Silnik solver-gleb
84 komendy, 93 testy
Rust, JSON na wejściu i wyjściu, rejestr narzędzi z polskimi opisami i jednostkami. Stan z 11.11, w budowie: ciśnienia, cementowanie, hydraulika, przewód, rury okładzinowe, jednostki; brak jeszcze karty likwidacji erupcji i kosztu metra.
Co znaleziono po drodze
kilkadziesiąt rozbieżności w przykładach
Część to pomyłki rachunkowe w samych książkach (np. mnożenie przez współczynnik wyporu zamiast dzielenia, pominięty marsz w koszcie świdra), część stałe z literówkami i błędy OCR; do tego zaokrąglenia IWCF decydujące o wyniku. Solver sprawdzony na kilku źródłach bywa pewniejszy niż pojedyncza książka.

Kolejność: jednostki i zadania z kolokwiów wydziałowych → hydraulika, kontrola otworu, ciśnienia, rury, przewód, cementowanie → arkusze projektu otworu (z listą brakujących danych i jawnymi założeniami) → generator danych do strojenia → pilotaż na 1B → strojenie 3B. Osobny tor: narzędzia opisane w kontekście, żeby model obsłużył także narzędzie, którego nie widział w treningu (na wzór serwerów MCP).

Część II · Instrukcja odtworzenia

Odtworzenie Stanisława od zera krok po kroku

Instrukcja dla człowieka bez asystenta AI. Każdy etap ma cel, wejście, dokładną komendę ze skryptu w repozytorium kod/, wyjście, czas na naszym sprzęcie, sposób sprawdzenia i znane pułapki. Źródła: skrypty w repo, docs/HANDOFF_2026-11-09.md, docs/HANDOFF_2026-11-10.md, docs/DANE_1B_research_2026-11-07.md i dziennik projektu na atari. Każda liczba pochodzi z kodu albo z dziennika; czego nie da się ustalić ze źródeł, jest oznaczone jako do uzupełnienia, zamiast zgadywać.

deterministyczne: sam kod, bez modelu wymaga lokalnego modelu-nauczyciela (nie asystenta AI) do uzupełnienia: brak w kodzie i dzienniku
Przepływ

Schemat etapów

Strzałki ciągłe to zależność danych (wyjście etapu jest wejściem następnego). Linia przerywana to pętla ewaluacji: wyniki etapu 10 decydują o kolejnych rundach SFT i o danych SFT. Ramka złota oznacza etap, który w obecnym przepisie korzysta z lokalnego modelu-nauczyciela.

Etapy 1-11

Instrukcja

Konwencja ścieżek: na obu serwerach jest to osobny katalog projektu z prawami tylko dla właściciela (chmod 700). Wszystkie skrypty zakładają, że są uruchamiane z tego katalogu, a kod leży w podkatalogu kod/. Każdy skrypt kończy się znacznikiem w logu (np. TRENING_GOTOWY); kontrola polega na sprawdzeniu znacznika i liczb w plikach statystyki.json albo log.jsonl.

1

Sprzęt i środowisko

czas: konfiguracja, bez pomiaru
Cel
Dwie maszyny o dwóch rolach: zen5 do pretreningu i SFT (bf16), atari do ewaluacji, solverów, indeksu RAG i parafraz (fp16).
Sprzęt
  • zen5: 8 × RTX PRO 6000 Blackwell 96 GB, PCIe bez NVLink. Katalog projektu, venv w venv/, Python 3.14 (handoff 10.11). Trening w bf16 z torch.compile, DDP przez torchrun. W czasie prac karty 0, 1, 6, 7 bywały zajęte przez właściciela maszyny; skrypty podają karty jawnie przez CUDA_VISIBLE_DEVICES.
  • atari: 6 × Tesla V100 32 GB (sm_70). Katalog projektu. venv: torch 2.10.0+cu128, sentencepiece 0.2.3, pyarrow 26, lm-evaluation-harness 0.4.13, transformers 5.22.2 (dziennik 07-08.11). Trening w fp16 z GradScaler. Karty nietykalne w czasie prac: 0 (model studentów), 2 (reranker), 3 (model 27B produkcji).

Do uzupełnienia: wersje pakietów venv na zen5 (torch, CUDA) nie są zapisane w repo ani w dzienniku; brak pliku requirements.

Zasady
  • Każde ciężkie zadanie CPU pod systemd-run --user --scope -p MemoryMax=… i z ograniczoną pulą procesów (lekcja OOM 07.11, dziennik).
  • tmux nie dziedziczy zmiennych środowiska wywołującego: zmienne wprost w poleceniu (kod/start_zen5.sh:8-9).
  • Stałe env każdego biegu: STAN_TOK (ścieżka do tokenizera), CUDA_DEVICE_ORDER=PCI_BUS_ID, PYTORCH_ALLOC_CONF=expandable_segments:True.
Kontrola
Test dymny 1M end-to-end (kod/smoke_1m.sh, karta 4 na atari): pretrening 3000 kroków × 32k tok ≈ 98 mln tokenów, ~450 tys. tok/s, ~4 min; val bpb 2,04 (krok 500) → 1,60 (krok 3000); fp16 stabilne (grad_norm ~0,4, zero NaN). Następnie SFT 1500 kroków i eval --n 500. Znacznik SMOKE_GOTOWY. Jeśli ten test przechodzi, środowisko jest sprawne.
2

Pozyskanie korpusów

czas: do uzupełnienia (zależy od łącza)
Cel
Zebrać surowe źródła polskie: web, PDF-y, korpus kuratorowany, archiwum HPLT, artykuły domenowe i teksty branżowe. Pobierać bezpośrednio na zen5 (łącze ~0,7 MB/s czyni przesył z atari niepraktycznym; dziennik 07.11).
Źródła
ZbiórRozmiar / rolaLicencjaSkrypt
HuggingFaceFW/fineweb-2, pol_Latn226 GB parquet; 152 mln dok.; web, bazaODC-Bypobierz_fineweb2.sh
epfml/FineWeb2-HQ-Plus, pol_Latn42,1 GB; górne 10% FW-2 wg klasyfikatora XLM-RODC-Bypobierz_hf.sh → korpus/fw2hqplus_pol
HuggingFaceFW/finepdfs, pol_Latn79,7 GB; PDF: nauka, normy, technikaODC-Bypobierz_hf.sh → korpus/finepdfs_pol
HuggingFaceFW/finepdfs-edu, pol_Latn16,9 GB; górne 10% FinePDFs; proza fachowa, wyżarzanieODC-Bypobierz_hf.sh → korpus/finepdfs_edu_pol
HPLT 3.0, pol_Latn, biny 9-10~94 GB jsonl.zst (całość 406,6 GB); spoza HFCC0 (opakowanie)pobranie: do uzupełnienia; konwersja hplt_do_parquet.py
SlayerLab/polish-dynaword (bez TED)8,9 GB; 17,1 mld znaków; kuratorowanyper dokument (kolumna license); TED bez licencji, pominiętypobierz_dynaword.py
Domena PL (czasopisma)2340 art., 55 mln znaków PL: Nafta-Gaz 1380, Wiertnictwo NG 372, Annales UMCS B 183, Prz. Geofiz. 169, PPGOS 117, Energetyka Rozpr. 79, AGH DOG 40CC BY / CC BY-SA wg wydawcy; AGH i PPGOS bez CC w metadanych (decyzja: zostawione)skrypt zbierający poza repo: do uzupełnienia; format korpus/domena/*/*.jsonl
Teksty branżowe210 książek PDF + 59 OCR = 301 MB tekstu, 32 mln znaków PLchronione prawem autorskim; art. 26² pr. aut. (TDM do badań, AGH, bez korzyści majątkowej); tylko upoważnieni, nie publikujemyrejestr.py → rejestr_zrodel.json
Komendy
# zen5, katalog projektu; pobieranie wznawialne (curl -C -), 4 wątki (xargs -P 4)
bash kod/pobierz_fineweb2.sh                       # → korpus/fineweb2_pol/, znacznik FINEWEB2_GOTOWE
bash kod/pobierz_hf.sh <repo> <ścieżka w repo> <cel> # ogólny; argumenty użyte dla HQ-Plus/FinePDFs/Edu: do uzupełnienia
STAN_ROOT=$PWD python3 kod/pobierz_dynaword.py > dziennik/pobierz.log 2>&1   # pomija data/ted_pl*, znacznik DYNAWORD_GOTOWE
# HPLT: jsonl.zst → parquet (text, url, id), szardy po 200 000 dok., 1 proces na plik; log dziennik/hplt_do_parquet.log
venv/bin/python kod/hplt_do_parquet.py             # → korpus/hplt3_pol_pq/, znacznik HPLT_PQ_GOTOWE

Zasady zbierania domeny (docs/DANE_1B_research): bez obchodzenia blokad (PAN/Incapsula tylko za zgodą wydawcy), limit ~1 żądanie/s, User-Agent z kontaktem.

Wyjście
Katalogi korpus/fineweb2_pol, fw2hqplus_pol, finepdfs_pol, finepdfs_edu_pol, hplt3_pol_pq, dynaword/data/<źródło>/*.parquet, domena/*/*.jsonl (pola: jezyk, tekst, doi, url_pdf, tytul), branzowe/*/*. Łącznie przed deduplikacją: 1175 plików, 243 GB (bez branżowych).
Kontrola
Znaczniki GOTOWE w logach; pobierz_dynaword.py zapisuje _lista_plikow.json (path, size) i pomija pliki o zgodnym rozmiarze, więc ponowne uruchomienie weryfikuje komplet. Uwaga: po deduplikacji (etap 4) surowe pobrania FW-2 (211 GB), HQ-Plus (40), FinePDFs (75) i HPLT (94) zostały skasowane z zen5 za zgodą; przy odtwarzaniu trzeba je pobrać ponownie.
3

Tokenizer SentencePiece Unigram 32k (v3)

czas: do uzupełnienia
Cel
Polski tokenizer o słowniku 32 768, który trzyma terminy branżowe w całości (ciśnienie, hydrostatyczne, wiertniczy, świder) i ma lepszą kompresję niż tokenizery ogólne.
Wejście
Próbka ok. 2 mld znaków (CEL = 2_000_000_000, seed 20261108) z 10 źródeł wg udziałów: fw2_hqplus 0,30 · fw2_reszta 0,15 · finepdfs_edu 0,12 · finepdfs 0,08 · wikipedia 0,12 · biblioteka_nauki 0,08 · wolne_lektury 0,03 · eurlex 0,03 · parliamentary 0,02 · govpl 0,02. Dokument wchodzi z prawdopodobieństwem 0,3; teksty branżowe ×6 (filtr diakrytyków > 0,004 = PL). Ostatni plik każdego źródła odłożony do testu kompresji (kod/tokenizer_v3.py:2-21).
Komenda
# zen5; skrypt bez argumentów, STAN_ROOT domyślnie katalog projektu
venv/bin/python kod/tokenizer_v3.py              # znacznik TOKENIZER_V3_GOTOWY
# parametry SentencePieceTrainer (tokenizer_v3.py:52-55): model_type=unigram, vocab_size=32768,
# character_coverage=0.9999, byte_fallback, split_digits, input_sentence_size=30_000_000,
# num_threads=120, max_sentence_length=8192, pad/unk/bos/eos = 0/1/2/3, train_extremely_large_corpus
Tokeny specjalne
69 symboli użytkownika (user_defined_symbols): 13 struktury (<pytanie> </pytanie> <odpowiedz> </odpowiedz> <kontekst> </kontekst> <zrodlo> </zrodlo> <wywolanie> </wywolanie> <wynik> </wynik> <odmowa>), 6 narzędzi (<f:hydrostatyka> <f:strata_rura> <f:mcm> <f:trajektoria_hdd> <f:reologia_fit> <f:brak_narzedzia>), 50 zapasowych <rez_00>…<rez_49>. EOS = 3 jest separatorem dokumentów we wszystkich plikach .bin.
Wyjście
tokenizer/stanislaw_unigram32k_v3.model (+ .vocab, .meta.json, probka_v3.txt). Wcześniejsze wersje v1/v2 (16 384, atari, tokenizer.py, tokenizer_v2.py) służyły modelom 1M-125M; plik tokenizer/stanislaw.model to v2 (krok kopiowania/zmiany nazwy: brak w kodzie).
Kontrola
Test kompresji na odłożonym tekście (skrypt drukuje go na końcu): v3 vs v2 w znakach/token: web HQ 4,78 vs 4,06; web 4,55 vs 3,87; PDF 4,00 vs 3,59 (dziennik 08.11 00:10). Dla v2 na dokumentacji poza treningiem: 2,28 tok/słowo (Qwen3.8 248k: 2,57). Sprawdzić też, że terminy branżowe kodują się jednym tokenem (kod/test_tok2.py <plik.model>).
4

Deduplikacja krzyżowa (dedup3b)

czas: ~2,3 h na 64 rdzeniach (zmierzone)
Cel
Usunąć dokumenty powtarzające się między źródłami (web vs HQ-Plus vs PDF vs DynaWord vs HPLT), zachowując kopię z najcenniejszego źródła. Wewnątrz jednego źródła near-duplikaty nie są usuwane (źródła HF są już deduplikowane).
Metoda
Kolejno (kod/dedup3b.py): (1) dokładny hash tekstu xxh64 (lower, zwinięte białe znaki), także wewnątrz źródła; (2) URL tylko między źródłami (znormalizowany: bez schematu, www., #, końcowego /; wyłączone dla par HQ-Plus/FW-2 i Edu/FinePDFs); (3) MinHash LSH na 5-gramach słów, 14 pasm × 8 hashy (jak FineWeb-2), tylko krzyżowo; wspólne jedno pasmo = kandydat, potem spójne składowe (scipy); (4) w składowej zostaje źródło o najwyższym priorytecie: dynaword > finepdfs_edu > fw2hqplus > finepdfs > fineweb2 > hplt3. Normalizacja tekstu wg datatrove simplify_text. Zadania po 200 000 wierszy; HPLT usuwany tylko po URL.
Komendy
# zen5; kod/dedup3b_pelny.sh (etapy wznawialne: plan, sig, match, write, sample, all)
RUN="systemd-run --user --scope -p MemoryMax=200G nice -n 15 venv/bin/python kod/dedup3b.py"
$RUN plan
$RUN sig --procs 64
# czeka na HPLT_PQ_GOTOWE w dziennik/hplt_do_parquet.log (konwersja z etapu 2)
$RUN plan --hplt                                  # HPLT na końcu planu: ID zadań i sygnatury bez HPLT zostają ważne
/usr/bin/time -v $RUN all --procs 64
cp korpus/dedup3b_work/statystyki.json korpus/dedup3b/statystyki.json   # znacznik DEDUP3B_GOTOWE
# po OOM w zapisie (08.11): kod/dedup3b_dokoncz.sh = find korpus/dedup3b -name "*.tmp" -delete; $RUN write --procs 64; $RUN sample
Wyjście
korpus/dedup3b/<src>/<src>__[<pod>__]<plik>__<grupa>.parquet (zstd 6; kolumny text, src, url, id, quality_score, edu). Sygnatury w korpus/dedup3b_work (30 GB) warto zachować do dokładania źródeł. Wynik (dziennik 08.11 16:42): dokumenty 213,6 mln → 179,0 mln (−16,2%), znaki 925 G → 715 G (−22,7%), czyli ok. 150-170 mld tokenów v3 (szacunek; po późniejszym pomiarze ~175 mld). Po źródłach (G znaków po dedupie): DynaWord 17,06 · FinePDFs-Edu 27,71 · HQ-Plus 49,90 · FinePDFs 119,53 · FW-2 384,10 · HPLT (10+9) 116,94.
Kontrola
$RUN sample losuje 20 par (seed 0, połowa dokładnych, połowa near-dup) i liczy Jaccard 5-gramów. Wynik 08.11: 18 prawdziwych duplikatów, 2 pary to ten sam URL z inną treścią (reguła URL) → 1,62 mln dokumentów do przywrócenia. dedup3b_analiza.py rozbija przyczyny usunięć near-dup (pasmo / URL / łańcuch).
Pułapki
Strumień zstd HPLT czyta się 20 MB/s i nie da się dzielić → najpierw konwersja do parquet. Zbieranie 200 tys. długich dokumentów w listach × 64 procesy > 200 GB RAM → zapis strumieniowy przez ParquetWriter paczkami po 5000 (dedup3b.py:345-354). Dysk zen5 po dedupie: 264 GB wolne (97%).
5

Mieszanki 1B i 3B oraz odkażanie względem testów

czas: do uzupełnienia (mieszanka v1 2 mld tok: ~6 min, 24 proc.)
Cel
Z korpusu zbudować pliki train.bin, anneal.bin (dane fazy wyżarzania) i val.bin w formacie uint16 z EOS=3, w zadanych kwotach tokenów na źródło, bez dokumentów pokrywających się ze zbiorami testowymi.
Mieszanka 1B
kod/mieszanka_1b.py (źródło: korpus przed dedup3b). Plan w mld tokenów: train hqplus 9,0 · fw2_reszta 6,0 · finepdfs 4,5 · finepdfs_edu 1,5 · dynaword 4,0 · branżowe 0,1; anneal finepdfs_edu 1,0 · hqplus_top 0,8 (quality_score ≥ 0,8) · wikipedia 0,4 · biblioteka_nauki 0,3 · wolne_lektury 0,15 · branżowe 0,05 · domena 0,1. Prawne w DynaWord przycięte do 35%; val 0,2% dokumentów; 64 procesy; mnożnik = kwota/dostępne (część całkowita = powtórzenia, ułamek = losowa kopia). Wynik (dziennik 08.11): train 25,43 mld (HQ-Plus 9,0 · FW-2 5,9 · FinePDFs 4,57 · Edu 1,55 · DynaWord ×1,6 4,3 · branżowe ×7,7 0,095), anneal 2,81 mld, val 0,317 mld. Artykuły domenowe odłożone do ewaluacji (137, lista ewal_wlasne/domena_heldout_klucze.json z ewal_wlasne_buduj.py) są wykluczone.
venv/bin/python kod/mieszanka_1b.py [--tylko-pomiar]   # → dane/mieszanka_1b/{train,anneal,val}.bin, statystyki.json; znacznik MIESZANKA_1B_GOTOWA
# wyżarzanie z domeną (dodane w trakcie biegu 1B): anneal_z_domena.bin = anneal.bin + 2226 art. × 3 (18,7 mln tok) = 2,870 mld
venv/bin/python kod/anneal_domena.py
Mieszanka 3B
kod/mieszanka_3b.py (źródło: korpus/dedup3b). Plan w mld tokenów: train fineweb2 22,0 · finepdfs 10,0 · fw2hqplus 10,0 · hplt3 8,0 · dynaword 4,5 · finepdfs_edu 5,0 · branżowe 0,15; anneal finepdfs_edu 2,0 · hq_top 2,0 (górne 20% HQ-Plus wg quality_score, próg z próbki 1%) · wikipedia 0,8 · biblioteka_nauki 0,6 · wolne_lektury 0,3 · branżowe 0,1 · domena 0,2. Val 0,1%; 16 procesów. Wynik (handoff 10.11): train 60,4 mld (fineweb2 22,1 · finepdfs 10,1 · fw2hqplus 10,0 · hplt3 8,2 · dynaword 4,7 · finepdfs_edu 5,2 · branżowe 0,14), anneal 6,2 mld, val 0,17 mld. FW-2 i HPLT w dedup3b nie mają quality_score, więc próbkowane losowo (HPLT = tylko biny 9-10).
# pamięć: 48 i 24 procesy = OOM w scope 60G; działa 16 proc. przy MemoryHigh 64G / MemoryMax 80G (handoff 10.11)
systemd-run --user --scope -p MemoryHigh=64G -p MemoryMax=80G venv/bin/python kod/mieszanka_3b.py --odkaz   # → dane/mieszanka_3b_odkaz; log dziennik/mieszanka_3b_odkaz.log
venv/bin/python kod/mieszanka_3b.py --tylko-anneal       # przebudowa samego anneal.bin (os.replace: działający trening trzyma stary i-węzeł)

Do uzupełnienia: dokładna linia uruchomienia mieszanka_3b.py --odkaz nie jest w repo (skrypty 3B tylko czekają na jej log); powyższa łączy parametry pamięci z handoffu z flagą ze skryptu.

Odkażanie
Dwa przejścia i bramka:
  • W mieszance (--odkaz): zbiór 13-gramów tokenów ze zbiorów testowych, które występują w dokładnie jednym dokumencie testowym; dokument treningowy odpada przy ≥ 10 różnych trafieniach (PROG_ODKAZ = 10, ok. 22 kolejne wspólne tokeny). Dotyczy train, anneal i val.
  • Po plikach .bin (kod/odkaz_bin.py <we> <wy>): próg względny min(10, ceil(0,5 × liczba 13-gramów dokumentu testowego)); frazy wspólne dla > 3 dokumentów testowych pomijane jako szablony; 13-gram nie przechodzi przez EOS. Wprowadzone po bramce 10.11 11:03, na której PolEval był skażony w 15%.
  • Skan kontrolny (kod/skazenie_13gram.py <train.bin>): dla każdego dokumentu testowego odsetek jego 13-gramów obecnych w treningu; „skażony” = ≥ 50%. Zbiory: ewal_wlasne/domena_heldout.parquet, terminologia.jsonl, ewal/dane/*/{test,validation,dev}, cały poleval2018_10k.
# z kod/s3b_8kart_v2.sh: odkażanie 2. przejścia, skan i bramka
systemd-run --user --scope -p MemoryHigh=40G -p MemoryMax=56G nice -n 15 venv/bin/python kod/odkaz_bin.py dane/mieszanka_3b_odkaz dane/mieszanka_3b_odkaz2 > dziennik/odkaz2.log 2>&1
systemd-run --user --scope -p MemoryHigh=36G -p MemoryMax=48G nice -n 15 venv/bin/python kod/skazenie_13gram.py dane/mieszanka_3b_odkaz2/train.bin > dziennik/skazenie_odkaz2.log 2>&1
# bramka: domena_heldout skazone_50 == 0 oraz poleval2018_10k/train skazone_50 < 0,01; inaczej STOP, 3B nie startuje

Wynik 10.11 (s3b_start4.sh:2-3): domena 0% skażonych, PolEval 1,1% (próg 1% przekroczony o 0,1 pp; dane uznane za czyste, PolEval raportowany na czystym podzbiorze, etap 10).

Kontrola
Znaczniki MIESZANKA_1B_GOTOWA / MIESZANKA_3B_GOTOWA, ODKAZ2_GOTOWE, SKAZENIE_GOTOWE; liczby tokenów per źródło w statystyki.json (porównać z planem), pomiar.json (znaki/token per źródło), skazenie_13gram.json (pola dok, skazone_50, jakikolwiek_13gram, sredni_odsetek).
Pułapki
Python 3.14 na zen5 startuje procesy przez forkserver, więc globalne zmienne (progi, zbiory id) nie trafiają do Pool: w mieszance 3B próg hq_top nie działał (naprawione 10.11 04:37), a w mieszance 1B filtry id (fw2_reszta bez HQ-Plus, finepdfs bez Edu) najpewniej nie działały → część dokumentów 2× w 1B (do sprawdzenia, nie naprawiane wstecz). Lekarstwo: get_context("fork").Pool albo initializer. Zbiory id trzymać jako posortowane np.uint64, nie obiekty Pythona (kopiują się do każdego procesu). splitlines() tnie po U+2028/U+0085 wewnątrz JSON → split("\n").
6

Pretrening 1B (WSD, wyżarzanie z domeną) i 3B

czas: 1B 41 h (zmierzone) · 3B ≈ 9 dni na 8 kartach (tempo zmierzone, bieg trwa)
Cel
Model bazowy języka. Trener to jeden plik kod/stanislaw.py (wzorzec llama2.c / nanoGPT): dekoder z RMSNorm, RoPE, SwiGLU, SDPA, wspólne wagi wejścia i wyjścia, AdamW (β 0,9/0,95, fused), clip 1,0, weight decay 0,1 na macierzach. Harmonogram WSD: warmup → stałe lr → liniowe wygaszanie w ostatnich 10% kroków na danych anneal.bin. Checkpoint <out>/ckpt.pt co --co_ile kroków, zapis przez .tmp i os.replace; ponowne uruchomienie tego samego skryptu wznawia z checkpointu z nowymi oknami danych (seed przesunięty o krok).
Przed 1B
Skalowanie w dół było sprawdzane po drodze: 30M (kształty 512×7, 384×14, 320×20; 31 800 kroków × 65 536 tok ≈ 2,08 mld, ~4,1-5,5 h na V100; kod/pre_30m.sh) i 125M (768×16, 4 karty DDP, 9540 kroków × 262k; kod/start_zen5.sh). Wnioski: kształt przy 30M bez znaczenia (różnice ~0,01 bpb), 30M→125M −0,12 bpb; web w mieszance konieczny (125M na samym DynaWord przegrywał na FineWeb-2). Nie jest to warunek odtworzenia 1B, ale tani test całej ścieżki.
1B: komenda
# kod/start_1b.sh (zen5, 8 kart). Czeka na MIESZANKA_1B_GOTOWA. Uruchomienie: tmux new -d -s stan-1b kod/start_1b.sh
env STAN_TOK=$PWD/tokenizer/stanislaw_unigram32k_v3.model CUDA_DEVICE_ORDER=PCI_BUS_ID PYTORCH_ALLOC_CONF=expandable_segments:True \
  nice -n 5 venv/bin/torchrun --standalone --nproc_per_node 8 kod/stanislaw.py pretrain --dane $PWD/dane/mieszanka_1b \
  --dtype bf16 --kompiluj 1 --out przebiegi/s1b --dim 2048 --layers 22 --heads 16 --hidden 5632 --seq 2048 \
  --batch 8 --akum 8 --kroki 26700 --warmup 2000 --lr 4e-4 --lr_min 4e-5 --harmonogram wsd --anneal 0.1 \
  --ewal 500 --ewal_batchy 20 --co_ile 250 >> dziennik/s1b.log 2>&1
# partia globalna = 8 × 8 × 8 × 2048 = 1 048 576 tok/krok; 26 700 kroków ≈ 28 mld tok; wyżarzanie od kroku 24 030

Model: 1,198 mld wag (2048 × 22, 16 głów, SwiGLU 5632, kontekst 2048, słownik 32 768). DDP z no_sync na mikropartiach (all-reduce raz na krok, kluczowe przez PCIe). Przepustowość ~200 tys. tok/s łącznie (~23,7 tys. na kartę).

Wyżarzanie z domeną w trakcie biegu (kod/restart_anneal.sh, tmux stan-restart-anneal): czeka na wpis "krok": 24000 w logu, zabija sesję stan-1b, czeka aż pamięć kart < 4000 MiB, podmienia anneal.bin na anneal_z_domena.bin (stary → anneal_bez_domeny.bin) i wznawia start_1b.sh z checkpointu. Przerwa 30 s (dziennik 09.11 11:35). Przy odtwarzaniu prościej zbudować anneal.bin z domeną od razu (etap 5).

3B: komenda
# kod/s3b_start8.sh (8 kart, bieg od 10.11) / kod/s3b_start4.sh (4 karty). Partia globalna stała: 512 × 2048 = 1,05 mln tok/krok
# wznowienie z przebiegi/s3b/ckpt.pt z identycznymi argumentami: kod/s3b_wznow.sh (odmawia, gdy bieg żyje albo karty są zajęte)
ARCH="--dim 3072 --layers 26 --heads 24 --hidden 8192 --seq 2048 --rope_base 500000"
WSP="--kroki 57000 --warmup 2000 --lr 3e-4 --lr_min 3e-5 --harmonogram wsd --anneal 0.1 --ewal 1000 --ewal_batchy 20 --co_ile 200 --migawki 5000 --dtype bf16 --kompiluj 1"
CUDA_VISIBLE_DEVICES=0,1,2,3,4,5,6,7 venv/bin/torchrun --standalone --nproc_per_node 8 kod/stanislaw.py pretrain \
  --dane dane/mieszanka_3b_odkaz2 --out przebiegi/s3b $ARCH $WSP --batch 2 --akum 32 >> dziennik/s3b.log 2>&1
# 4 karty: CUDA_VISIBLE_DEVICES=2,3,4,5 … --nproc_per_node 4 … --batch 2 --akum 64
# opcjonalnie --zero 1 (ZeRO-1, stany AdamW dzielone między karty): bez zysku tok/s (34,8 vs 35,6 tys.), mniej pamięci

Model: 3,045 mld wag (d = 3072, 26 warstw, 24 głowy po 128, SwiGLU 8192, RoPE 500k od zera, kontekst 2048). 57 000 kroków = 60 mld tokenów. Zmierzone: 2 karty 19,5 tys. tok/s (~54 s/krok), 4 karty 35,6 tys. tok/s (8,9 tys. na kartę, 82 GB/kartę), 8 kart ~77,6 tys. tok/s (~13,5 s/krok) → ≈ 9 dni. Checkpoint co 200 kroków (36,5 GB ze stanem optymalizatora, zmierzone); --migawki 5000 zapisuje same wagi bf16 (wagi_k<krok>.pt) do ewaluacji w trakcie. Checkpoint ładowany z mmap=True, żeby ranki dzieliły stronice.

Czujka (kod/s3b_czujka.py --wznawiaj 3, tmux stan-czujka na zen5) co minutę sprawdza liczbę procesów, świeżość logu, stratę (NaN, skok o 1,0 ponad minimum okna) i walidację (wzrost o 0,15). Gdy po checkpoincie pojawi się w logu skończona strata, oznacza go jako sprawdzony (twarde dowiązanie ckpt_dobry.pt, bez kopiowania 36 GB). Przy padzie procesów sama woła s3b_wznow.sh, najwyżej trzy razy; przy złej stracie nie wznawia. Stan w dziennik/s3b_czujka_stan.json, zdarzenia w dziennik/s3b_czujka.log. Ręczny powrót do sprawdzonego stanu: ln -f przebiegi/s3b/ckpt_dobry.pt przebiegi/s3b/ckpt.pt, potem s3b_wznow.sh. Panel na żywo na tej stronie zasila kod/panel_stan_zbierz.py (zen5) przez kod/panel_stan_push.sh (Mustang, co 2 min).

Walidacja 3B (bpb na odłożonej części mieszanki 3B): 1,257 (krok 1000), 1,073 (2000), 0,955 (3000), 0,947 (4000), 0,884 (5000), 0,844 (6000). Nie porównywać wprost z krzywą 1B: inna mieszanka walidacyjna.

Wyjście
przebiegi/s1b/ckpt.pt (wagi fp32 + AdamW + skaler + cfg + krok), log.jsonl (krok, strata, lr, grad_norm, tok_s, val_strata, bpb co --ewal). Same wagi: venv/bin/python kod/tylko_wagi.py przebiegi/s1b/ckpt.pt przebiegi/s1b_final_wagi.pt (1B bf16: 2,4 GB wg plakietki). Rozmiar checkpointu z optymalizatorem: 16 B/parametr (1B: do uzupełnienia; 3B 36,5 GB, zmierzone).
Kontrola
W logu TRENING_GOTOWY i PRÓBKA: (60 tokenów od „Płuczka wiertnicza”, temperatura 0,8). Krzywa bpb na val mieszanki: 1B krok 20 300 → 0,826; w wyżarzaniu 0,80-0,86 (val = mieszanka webowa, 20 partii, szum). Po treningu (etap 10): bpb val mieszanki 0,583, domena odłożona 0,676, terminologia 0,907. Przy 3B kontrola w trakcie przez migawki. Trener zatrzymuje się sam przy stracie NaN/inf po warmupie (kod wyjścia 2).
Pułapki
3B: partia 4 na kartę mieści się na jednej karcie, ale z buforami gradientów DDP daje OOM → partia 2 i większa akumulacja. 1B wyżarzanie: podmiana pliku w trakcie biegu wymaga zabicia procesów i sprawdzenia pamięci kart przed restartem. Bieg dłuższy niż kilka dni na współdzielonej maszynie: ustalić z właścicielem, które karty są wolne (karty 0, 1, 6, 7 były zajmowane ponownie).
7

Rozszerzenie kontekstu 1B do 8k

czas: ~7 h na 2 kartach (start 01:58, koniec ~9:00; z handoffu)
Cel
Dalszy pretrening bazy s1b_final z kontekstem 8192 i bazą RoPE 10 000 → 500 000 (ABF, arXiv:2309.16039), na ~1 mld tokenów z przewagą długich dokumentów (przepis Fu i in. 2024, arXiv:2402.10171), bez utraty jakości na 2k.
Dane
kod/kontekst8k_dane.py [mld_dlugich=1.2] [mld_krotkich=0.5]: dokumenty ≥ 4096 tokenów z FinePDFs-Edu, Wolnych Lektur, Biblioteki Nauki i domeny (bez odłożonych); 1% do val po hashu klucza; krótkie = losowe ciągłe kawałki po 1 mln tokenów z mieszanka_1b/train.bin (seed 8192); przeplot kawałków długich i krótkich. 24 procesy. Wynik: 73 332 długich dokumentów, 1,2 mld długich + 0,5 mld krótkich, val 11,5 mln (dziennik 09.11 22:34). Wyjście dane/kontekst8k/{train,val}.bin, statystyki.json, znacznik GOTOWE.
Komenda
# kod/kontekst8k_1b.sh (zen5, karty 3,4). Czeka na GOTOWE danych i SFT7_GOTOWY (zwolnienie kart)
CUDA_VISIBLE_DEVICES=3,4 venv/bin/torchrun --standalone --nproc_per_node 2 kod/stanislaw.py pretrain --dane dane/kontekst8k --out przebiegi/s1b_8k \
  --init przebiegi/s1b_final_wagi.pt --seq_sft 8192 --rope_base 500000 --dtype bf16 --kompiluj 1 \
  --batch 2 --akum 16 --kroki 2000 --warmup 100 --lr 1e-4 --lr_min 1e-5 --harmonogram wsd --anneal 0.2 --ewal 250 --ewal_batchy 10 --co_ile 250 \
  || { echo "$(date) KONTEKST8K_BLAD (trening)" >> dziennik/kontekst8k.log; exit 1; }
venv/bin/python kod/tylko_wagi.py przebiegi/s1b_8k/ckpt.pt przebiegi/s1b_8k_wagi.pt
CUDA_VISIBLE_DEVICES=3 venv/bin/python kod/ewal_kontekst.py przebiegi/s1b_8k_wagi.pt > ewal/wyniki/s1b_8k_kontekst.json 2>&1   # znacznik KONTEKST8K_GOTOWY
# 2000 kroków × 2 × 16 × 2 × 8192 = 524 288 tok/krok ≈ 1,05 mld tok; 42 tys. tok/s
Kontrola
kod/ewal_kontekst.py <wagi.pt> [n_okien=40] [n_hasel=8]: (1) bpb w oknach 8192 z kontekst8k/val.bin w koszach pozycji 0-1k / 1-2k / 2-4k / 4-8k; (1b) bpb na oknach 2048 z mieszanka_1b/val.bin jako kontrola regresji; (2) „hasło w stogu siana” (Mohtashami i Jaggi 2023): 5-cyfrowe hasło wstawione na głębokości 10/30/50/70/90% dokumentu o długości 2048/4096/8192, odpowiedź zachłanna do 8 tokenów. Linia bazowa s1b_final: hasło 2k 100%, 4k/8k 0%; bpb 0,72 (1-2k) → 1,31 (2-4k) → 2,14 (4-8k); bpb mieszanki 2k 0,830. Po 8k: hasło 97,5% na 4k i 8k, bez regresji na 2k (liczba z briefu; plik ewal/wyniki/s1b_8k_kontekst.json nie był czytany przy pisaniu tej strony).
Pułapki
Partia 4 × 8192 = OOM na 1B (logity 32k × 8192 w fp32) → partia 2 × akumulacja 16. Skrypt bez set -e wpisał fałszywe GOTOWE po padzie treningu → znacznik KONTEKST8K_BLAD i || exit 1.
8

Dane SFT: solver, parafrazy, RAFT, kontrast, odmowy

czas: generatory solverowe: minuty · parafrazy i RAFT: do uzupełnienia (godziny, zależne od nauczyciela)
Cel
Trzy rodzaje danych strojenia: a) wywołania narzędzi inżynierskich z deterministyczną prawdą z solvera, b) parafrazy pytań dla odporności na sformułowania, c) RAFT: odpowiedzi z dokumentów z cytatem źródła [n] albo odmowa. Doktryna: fakty w RAG, liczby w solverze, w wagach tylko zachowanie.
Uczciwie o nauczycielach
Co wymaga modelu-nauczyciela. Generatory solverowe, parser MCM, odmowy syntetyczne, podział i wydłużanie RAFT są czystym kodem (bez żadnego LLM). Parafrazy, pytania i odpowiedzi RAFT oraz sędzia par kontrastowych używają lokalnego modelu-nauczyciela serwowanego przez API zgodne z OpenAI (vLLM / SGLang). To nie jest asystent AI: człowiek uruchamia serwer modelu z wag otwartych i skrypty, które do niego odpytują; walidatory w kodzie odrzucają złe wyjścia. Użyte nauczyciele: Qwen3-30B-A3B-Instruct-2507 (Apache-2.0; parafrazy; dla RAFT odrzucony, bo polszczyzna za słaba), Qwen3.8-27B (RAFT, dane 1B) i Bielik-11B-v2.3-Instruct (RAFT, dane 1B). Zbiór testowy parafraz jest optymistyczny, bo ten sam nauczyciel parafrazował train i test.
a) Solver
Pięć narzędzi: hydrostatyka, strata_rura (modele bingham/pl/hb/newton), mcm (minimum curvature), trajektoria_hdd, reologia_fit (hb_12pt / bingham_12pt) + odmowy (<f:brak_narzedzia>, 12% rekordów: 60% pytania spoza narzędzi, 40% hydrostatyka bez danej). Prawdę liczy solver w Rust: solver_cli <komenda> (JSON na stdin, timeout 20 s). Format przykładu: <pytanie>…</pytanie><wywolanie><f:NARZ>{json}</wywolanie><wynik>{json}</wynik><odpowiedz>…</odpowiedz>; wynik formatuje deterministyczny KOMPAKT, blok <wynik> jest wyłączony ze straty (wstawia go solver w działaniu).
  • v1 generator_solver.py <katalog> [n=3000] (seed 20261107): wąskie zakresy, 3-8 szablonów na narzędzie, MCM 3-5 stacji; podział 70/20/10 (test = inne szablony; poza zakresem = parametry spoza treningu). Wynik: train 11 776 / test 3508 / poza 1516.
  • v2 generator_solver_v2.py <katalog> [n=4000] (seed 20261108): zakresy szerokie, log-jednorodne (np. rho 800-2500, L 20-12 000 m, q 0,001-0,15 m³/s), MCM 2-12 stacji, test poza_v2 z wartości skrajnych (MCM 13-16). Wynik: train 15 810 / test 4575 / poza_v2 2015. Lekcja: v1 wiązał liczbę z kluczem po wielkości i ucinał listy.
  • v3 generator_solver_v3.py <katalog_v3> [n=4000] [pliki do konwersji] (seed 20261109): umowa MCM, w której model emituje <f:mcm>{"zrodlo": "pytanie"}, a stacje wyciąga deterministyczny parsery.stacje_mcm (zwraca None, gdy niepewne → pyta człowieka); +6 szablonów trajektorii o różnej kolejności słów. Dane v3: 15 714 + parafrazy v1 25 728 + v2 21 806 = 63 248 przykładów.
  • v4 generator_solver_v4.py korpus/solver/v3/reologia_v4_train.jsonl [n=3000]: 6 szablonów pytań reologii z „granicą płynięcia” (po regresji w SFT3, patrz etap 9).
Antywzorzec potwierdzony pomiarem: LLM jako kopiarka tabel (MCM 13-16 stacji: 0-5% bez parsera, 99/99 z parserem).
b) Parafrazy
nauczyciel python3 kod/parafrazy.py <we.jsonl> <wy.jsonl> [na_rekord=2] [limit=0], 48 wątków, 6 stylów, temperatura 0,8, top_p 0,95, max 300 tokenów. Walidator twardy odrzuca parafrazę, gdy zmienił się multizbiór liczb, zginęła jednostka (kg/m3, m3/s, 1/s, Pa, mm, °), zmieniła się nazwa modelu reologicznego albo tekst jest > 3× dłuższy. Wynik train v1: 25 730 przyjętych (odrzuty: liczby 7382, model 1401, format 811); v2: 21 806. Nauczyciel: vLLM na atari, karta 5 (kod/atari_po_restarcie.sh:10):
CUDA_VISIBLE_DEVICES=5 vllm serve <wagi Qwen3-30B-A3B-Instruct-2507-AWQ> --served-model-name qwen3-30b-a3b \
  --quantization awq --tensor-parallel-size 1 --max-model-len 32768 --kv-cache-dtype fp8_e5m2 --gpu-memory-utilization 0.92
c) RAFT

Indeks (bez LLM generatywnego): python3 kod/rag_indeks_domena.py [równoległość=4] buduje kolekcję Qdrant stanislaw_domena z korpus/domena: fragmenty ~600 znaków z tytułem, osadzenia bge-m3 (1024, cosinus) przez Ollamę, indeks pełnotekstowy; ~25 fragm./s. Wynik: 139 721 fragmentów (106 764 PL). Druga kolekcja superwiertnik (253 174 fragm., ~91% EN) tylko do odczytu.

Generator nauczyciel: python3 kod/raft.py <wy.jsonl> [n=15000] [rown=32]. Env: QDRANT, OLLAMA, RERANK (adres rerankera), NAUCZ (adres API nauczyciela), MODEL_N, UDZIAL_WYROCZNI (domyślnie 0,8), PULAPKI_TRUDNE=1, SEED. Przebieg: pytanie od nauczyciela (120 tok, T 0,4) → wyszukiwanie hybrydowe 2 kolekcji + reranker (top 12) → kontekst: wyrocznia + 3 pułapki, albo bez wyroczni (połowa pułapek z pozycji 6-12, w trybie trudnym 4 najbliższe) → odpowiedź (300 tok, T 0,2) z kontrolami: odmowa ma jedną formę („Nie wiem - podane dokumenty nie zawierają odpowiedzi.”), odpowiedź musi cytować [nr wyroczni], wszystkie liczby muszą pochodzić z kontekstu albo pytania. Format: <kontekst><zrodlo>[n] src</zrodlo>tekst…</kontekst><pytanie>Q</pytanie>(<odmowa>)<odpowiedz>A</odpowiedz>.

Rozszerzenia: raft_kontrast.py <raft_train> <wy> [n=3000] [rown=48] sędzia TAK/NIE: usuwa wyrocznię, dokłada najbliższy dokument, nauczyciel (T 0, 5 tokenów) orzeka, czy da się odpowiedzieć; NIE → odmowa kontrastowa. raft_odmowy.py <we> <wy> <n> [ziarno=1] kod: odmowy syntetyczne (pytanie z a, kontekst z b; test tylko z przykładów testowych). raft_dlugi.py <we> <wy> [k_min=6] [k_max=10] [seed] kod: dokłada 6-16 dystraktorów i przenumerowuje [n] (dane dla SFT na bazie 8k). raft_podziel.py plik1.jsonl … <prefiks> kod: łączy i dzieli 95/5 po hashu wyroczni (ta sama wyrocznia nigdy w obu częściach).

Nauczyciele dla danych 1B (dziennik 09.11): Qwen3.8-27B przez SGLang na zen5 (karta 5) i Bielik-11B-v2.3 przez SGLang (karta 2), generatory na Mustangu przez tunele SSH. Do uzupełnienia: komendy startu SGLang i tuneli nie są w repo; brak też komend, które wytworzyły pliki odmowy_*, rall_*, r7_* (są tylko ich użycia w skryptach SFT). Zbiór r8: 20 564 rekordów (kontrast 1919, raft_v3_b 3086, raft_v3_q 1510); test rall 500 (158 odmów, w tym 78 trudnych od nauczyciela).

Kontrola
Znaczniki PARAFRAZY_GOTOWE, INDEKS_GOTOWY, RAFT_GOTOWY, KONTRAST_GOTOWY. Przed podziałem oczyścić JSONL (ucięta ostatnia linia, json.loads na każdej, pola wyrocznia i rodzaj; tak robi noc_sft8_mustang.sh:20-29). Odsetek przyjętych parafraz ~67% to norma. Pierwsza linia bazowa bez treningu: baseline_reguly.py <katalog> (słowa kluczowe + regex; v1 test: narzędzie 0,938, wynik 0,81, odmowa 0,515).
9

SFT: baza v3, strojenia wspólne (SFT6/SFT8), SFT na bazie 8k

czas: SFT v3 1B ~35 min (2 karty, zmierzone) · SFT10 na 2 × V100: 4 h 37 min (zmierzone) · SFT6/SFT8: do uzupełnienia
Cel
Nauczyć bazę zachowania: wybór narzędzia i argumenty (liczby kopiowane z pytania), odpowiedź z cytatem źródła, odmowa, gdy dokumenty nie zawierają odpowiedzi. Zasada potwierdzona pomiarem: jedno strojenie wspólne na całości danych jest lepsze niż kolejne strojenia (SFT6 > SFT5; dziennik 09.11 22:00).
Mechanika
Tryb stanislaw.py sft --init <wagi> --sft plik1.jsonl,plik2.jsonl,…. Maska straty (stanislaw.py:69-75): strata liczona od tokenu po </pytanie>; blok <wynik>…</wynik> bez straty; EOS dopisany; przykłady dłuższe niż kontekst odrzucane. Mnożnik danych = powtórzenie pliku na liście. --seq_sft N ustawia dłuższy kontekst (RoPE w locie). --kubelki 1: partie z jednego kubełka długości (512/1024/2048/4096/8192) o stałym budżecie tokenów B × T.
Przepisy
SkryptKartyStart (--init)Dane (--sft)Parametry
sft_1b_atari.sh (SFT v3, baza narzędzi)atari 4+5, fp16s1b_final_bf16.ptv3/solver_train, v3/v1p_…, v3/v2p_… (63 248)seq_sft 1024, batch 4, akum 8, 1500 kroków, warmup 50, lr 1e-4→1e-5 → s1b_sft_v3_wagi.pt
sft6_1b.sh (najlepszy zrównoważony)zen5 3,4, bf16s1b_sft_v3_wagi.ptv3 ×3 pliki, reologia_v4 ×2, rall_train ×2, rall_odmowy_train (98 451)seq 1536, batch 12, akum 2, 2000 kroków, warmup 50, lr 5e-5→5e-6
sft8_1b.sh (kandydat na najlepszy)zen5 2,5s1b_sft_v3_wagi.ptjak SFT6, ale r8_train ×2 zamiast rall2400 kroków, reszta jak SFT6
sft9_1b.shzen5 2,5s1b_sft_v3_wagi.ptSFT8 + r8_pozytywy_pulapki ×12400 kroków; cel: fałszywe odmowy ≤ 0,03 przy trudnych ≥ 0,65
sft10_atari.sh sft10atari 4+5, fp16s1b_sft_v3_bf16.ptprzepis SFT9 na r10 (r8 + kontrast2 1614 + raft_v4_b 2370 = 24 548 rek.)seq 1536, batch 1, akum 24 (partia 2 = OOM na 32 GB), 2400 kroków, lr 5e-5→5e-6
sft10_atari.sh sft10aatari 4+5, fp16s1b_sft_v3_bf16.ptprzepis SFT8 na r10 (więcej odmów w mieszance)jak sft10
sft8k_1b.sh etap Azen5 2-5, DDP ×4s1b_8k_wagi.ptv3 ×3seq 1024, batch 8, akum 2, 1500 kroków, lr 1e-4→1e-5 → s1b_8k_sft_v3_wagi.pt
sft8k_1b.sh etap Bzen5 2-5s1b_8k_sft_v3_wagi.ptv3 ×3, reologia_v4 ×2, r8_train, r8_train_dlugi, rall_odmowy_trainseq 8192, --kubelki 1, batch 2, akum 1, 2400 kroków, lr 5e-5→5e-6

Historia dojścia (SFT2-SFT5, sft2_1b.sh…sft5_1b.sh) jest w repo i w dzienniku; do odtworzenia wystarczy SFT v3 → SFT6 lub SFT8.

Komenda
# wzór (kod/sft6_1b.sh); tmux: env w stringu komendy
cd <katalog projektu>; export STAN_TOK=$PWD/tokenizer/stanislaw_unigram32k_v3.model CUDA_DEVICE_ORDER=PCI_BUS_ID PYTORCH_ALLOC_CONF=expandable_segments:True
cat dane_raft/rall_test.jsonl dane_raft/rall_odmowy_test.jsonl > dane_raft/rall_test_z_odmowami.jsonl
V=korpus/solver/v3; R=dane_raft
CUDA_VISIBLE_DEVICES=3,4 venv/bin/torchrun --standalone --nproc_per_node 2 kod/stanislaw.py sft --init przebiegi/s1b_sft_v3_wagi.pt --out przebiegi/s1b_sft6 \
  --sft $V/solver_train.jsonl,$V/v1p_solver_train_parafrazy.jsonl,$V/v2p_solver_train_parafrazy.jsonl,$V/reologia_v4_train.jsonl,$V/reologia_v4_train.jsonl,$R/rall_train.jsonl,$R/rall_train.jsonl,$R/rall_odmowy_train.jsonl \
  --dtype bf16 --kompiluj 1 --seq_sft 1536 --batch 12 --akum 2 --kroki 2000 --warmup 50 --lr 5e-5 --lr_min 5e-6 --ewal 1000
venv/bin/python kod/tylko_wagi.py przebiegi/s1b_sft6/ckpt.pt przebiegi/s1b_sft6_wagi.pt
# ewaluacja: ewal_raft.py (n=500 rall_test_z_odmowami, n=100 rall_test_trudne_odmowy) + ewal_narzedzia_dwuetapowo generuj (etap 10)

Dokładne listy plików i karty w każdym skrypcie kod/sftN_1b.sh; powyższy blok odtwarza skład SFT6 z tabeli.

Wyjście i wyniki
przebiegi/s1b_sftN_wagi.pt. Wyniki 1B (handoffy 09-10.11):
MiaraSFT6SFT7SFT8
Trudne odmowy (n=78)0,5000,5130,667
Odmowa trafna (500)0,8730,8610,930
Fałszywa odmowa (próg ≤ 0,03)0,0180,0180,035
Cytat wyroczni0,7960,7800,794
Liczby z kontekstu0,8630,8860,914
Narzędzia v2 / poza v2 / v1 poza / parafrazy0,982/1,000/0,970/0,9600,977/0,995/0,975/0,9770,982/1,000/0,960/0,966
Odniesienie: Qwen3.8-27B z narzędziami 0,996 wyniku solvera (v1 test); 1B po SFT v3 ≈ 27B w wywoływaniu solvera.

Test r10 (1079 pytań: 142 trudne odmowy, 937 pytań z odpowiedzią w dokumentach; wszystkie modele na tym samym sprzęcie, 2 × V100, 11.11):

MiaraSFT9SFT8SFT10SFT10a
Trudne odmowy (142)0,5350,6550,7890,859
Fałszywa odmowa (937)0,0480,0730,1260,186
w tym pytania z pułapkami (378)0,1080,1510,2780,381
w tym pytania z wyrocznią w kontekście (559)0,0070,0200,0230,054
Cytat wyroczni0,7620,7880,7820,794
Liczby z kontekstu0,8680,8860,8670,862

Wniosek: do RAG-u zostaje SFT8. Kolejne kroki po krzywej są coraz droższe (SFT9→SFT8: +17 trafnych odmów za +23 fałszywe; SFT8→SFT10: +19 za +50; SFT10→SFT10a: +10 za +56). Parowanie pytanie po pytaniu (test McNemara) potwierdza różnice (p rzędu 10-10 dla fałszywych odmów SFT8 wobec SFT10). Fałszywe odmowy siedzą w pytaniach z pułapkami, w których fragment-wyrocznia nie trafił do kontekstu, a odpowiedź trzeba złożyć z innych dokumentów; ok. 8% takich wzorców samo stwierdza „w dokumentach tego nie ma”, czyli dane mają szum w etykietach. Plan r11: przeetykietować te przypadki, osobna miara odmów wyrażonych prozą, dane uczące oceny, czy kontekst wystarcza.

Pułapki
SFT3 (RAFT + mało danych narzędziowych) zapomniał schematu reologia_fit: na szablonie testowym „granica płynięcia” model wybierał dobre narzędzie, ale schemat argumentów strata_rura (zwrot był w treningu tylko przy stracie ciśnienia) → generator v4 i strojenie wspólne. Próg na P(<odmowa>) (ewal_odmowa_prog.py) nie pomaga: w trudnych przypadkach model jest pewny odpowiedzi (granica 1B, nie kalibracji).
10

Ewaluacja

czas: linia bazowa Bielika polish_mc 68 min (V100, zmierzone) · reszta: minuty do godzin
Cel
Mierzyć osobno język (bpb), wiedzę fachową (terminologia), zachowanie (narzędzia, RAFT, odmowy) i kontekst (hasło). Zawsze na zbiorach odłożonych i, gdzie to możliwe, na czystym podzbiorze (bez skażenia 13-gramami).
Narzędzia
  • bpb na czystym podzbiorze kod: python kod/ewal_czysty.py <model.pt | katalog HF> <wyj.json> [n_poleval=2000]. Dla każdego dokumentu domeny odłożonej (137 art.) i PolEval 2018 liczy bpb = ΣNLL/ln2/Σbajtów w oknach bez nakładania oraz odsetek 13-gramów obecnych w danych 1B; raportuje podzbiory wszystkie / czyste_0 / ponizej_10 / skazone_50. Tak powstały liczby z części I (PolEval 0,924-0,929 vs Bielik 0,940; domena 0,686/0,723 vs 0,679).
  • bpb vs Goldfish: kod/bpb_porownanie.py <val.bin|parquet> <ckpt> [model_hf=goldfish-models/pol_latn_1000mb] [n_dok=2000] (uwaga: normalizacja Albert w Goldfish zbija białe znaki, przewaga po jego stronie).
  • Terminologia kod: pary zdań różniące się jednym terminem (poprawny vs kalka: świder/wiertło, szybkość/prędkość ścinania, wciąganie/przeciąganie, graniatka/kelly…), wynik = odsetek par, w których poprawne zdanie ma wyższe log-prawdopodobieństwo na bajt, poziom losowy 0,5. ewal_terminologia.py buduje terminologia.jsonl (23 terminy w kodzie), ewal_terminologia_licz.py <jsonl> {stanislaw:<ckpt>|hf:<repo>} liczy. Wersja użyta w wynikach: 86 par (CI ~±6-11 pp). Wyniki: 1B 0,907 · Bielik 11B 0,872 · Goldfish 125M 0,779 · Qwen3.8-27B 0,733.
  • Narzędzia, dwuetapowo kod: generacja na GPU bez solvera, ocena solverem bez GPU (nie trzeba przenosić wag przez łącze 0,6 MB/s):
    # zen5 (GPU): tasowanie Random(7), n z każdego zbioru, prompt <pytanie>…</pytanie><wywolanie>, 200 tokenów, dekodowanie ograniczone
    venv/bin/python kod/ewal_narzedzia_dwuetapowo.py generuj przebiegi/s1b_sft8_wagi.pt dziennik/sft8_gen.jsonl $V/solver_test.jsonl,$V/solver_test_poza_v2.jsonl,… 200
    # atari (solver): metryki wybor_narzedzia, wynik_solvera, odmowa, zly_json, per_narzedzie
    venv/bin/python kod/ewal_narzedzia_dwuetapowo.py ocen dziennik/sft8_gen.jsonl > ewal/wyniki/s1b_sft8_narzedzia.json
    Dekodowanie z ograniczeniem (stanislaw.py:204-245): liczby w argumentach JSON mogą być tylko liczbami skopiowanymi z pytania (prefiks kandydata w toku, pełny kandydat + znak ,]} po zamknięciu); sprawdzane top-256 logitów; stop na </wywolanie>.
  • RAFT kod: python kod/ewal_raft.py <ckpt> <raft_test.jsonl> [n=300]: generacja zachłanna 220 tokenów; odmowa = <odmowa> w pierwszych 20 znakach albo „Nie wiem” w 60; metryki odmowa_trafna, falszywa_odmowa (na pozytywach), cytat_wyroczni (czy odpowiedź zawiera [nr wyroczni]), liczby_z_kontekstu (każda liczba odpowiedzi występuje w kontekście lub pytaniu).
  • Rozbicie odpowiedzi RAFT kod: ewal_raft.py <wagi> <test.jsonl> <n> <rekordy.jsonl> zapisuje każdą odpowiedź z cechami pytania (rodzaj, nauczyciel, źródło, długość kontekstu, odmowa, cytat, liczby); kod/rozbicie_r10.sh robi to dla czterech modeli na atari, kod/raft_rozbicie.py nazwa=plik … liczy odmowy według cech i parowanie modeli testem McNemara. Generowanie zachłanne, więc sumy zgadzają się z ewaluacją bez zapisu.
  • Hasło w stogu siana i bpb wg pozycji: ewal_kontekst.py (etap 7).
  • Benchmarki polskie: lm-evaluation-harness 0.4.13 z zadaniami polish_mc skopiowanymi 1:1 z forka SpeakLeash (zgodność z Open PL LLM Leaderboard), rdzeń 15 zadań / 52 224 przykładów (polemo2, 8tags, belebele, dyk, ppc, psc, cbd, klej_ner, polqa, multiblimp_pol, hellaswag_pl, arc_easy/challenge_pl, bpb poleval2018_10k), „wiedza” (global_mmlu_pl, include_pl, llmzszl). Uruchamiane z ewal.py --model stanislaw:<wagi> --tok v3 --dtype bf16 --zadania polish_mc|rdzen|wiedza --fewshot 0 --batch N (kod/premiera_1b.sh, 4 karty równolegle). Do uzupełnienia: uprząż ewal.py i adapter stanislaw_lm.py leżą na serwerach w katalogu ewal/, nie w repo kod/.
Wyniki 1B bazowego
multiblimp 0,984 (Bielik 0,989); PolEval bpb 0,981 (Bielik 1,056; możliwa kontaminacja, stąd czysty podzbiór); hellaswag_pl 0,435 (0,706); arc_easy 0,443 (0,684); polish_mc i MMLU-PL na poziomie losowym (model bazowy bez strojenia do poleceń; Bielik polish_mc 0,555, Qwen3.8-27B 0,456). Wniosek z premiery: 1B to mocny model języka (gramatyka ~Bielik, bpb lepsze), bez wiedzy ogólnej; zgodnie z doktryną wiedza w RAG, liczby w solverze.
Linie bazowe
kod/linie_bazowe_atari.sh (Bielik-11B-v2.3-Instruct fp16 na karcie 1, lm-eval 0-shot, partia 8 → OOM przy długich promptach „wiedzy”; linie_bazowe_atari2.sh z partią 1-2), baseline_27b.py <katalog> [n=300] (Qwen3.8-27B przez ninfer, 5 schematów narzędzi, temperatura 0). Qwen3.8-27B tylko na zen5 (bf16), nigdy przez HF fp16 na V100 (etap 11).
11

Miny i lekcje

źródła: handoffy 09-10.11, dziennik
Lista
  1. OOM przez fork z korpusem w RAM (atari, 07.11 20:35)

    tokenizuj.py v1 trzymał korpus w pamięci i forkował Pool(80) na 96 wątkach; copy-on-write skopiował strony w każdym procesie, load ~97, sshd nie odpowiadał ~10 min, OOM zabił proces (43 GB). Reguła: shardy na dysku, 24 procesy, nice 10, zawsze systemd-run --scope -p MemoryMax=….

  2. Python 3.14: forkserver zamiast fork (zen5)

    Globalne zmienne nie trafiają do procesów Pool: próg hq_top w mieszance 3B nie działał, filtry id w mieszance 1B najpewniej też (część dokumentów 2×). Lekarstwo: get_context("fork").Pool albo initializer.

  3. Qwen3.8 (Gated DeltaNet) przez HF transformers fp16 na V100 = Xid 31 → Xid 154 na wszystkich kartach (09.11 05:15)

    Bez jąder flash-linear-attention referencyjne jądra PyTorch dały „too many resources requested for launch”, potem MMU fault; nowe procesy nie inicjalizowały CUDA aż do restartu węzła (kod/atari_po_restarcie.sh odtwarza usługi spoza systemd). Nowe architektury NIE przez HF na V100; Qwen3.8 tylko na zen5.

  4. OOM w treningu

    8k: partia 4 × 8192 na 1B (logity) → 2 × akum 16. 3B: partia 4 mieści się na jednej karcie, ale bufory gradientów DDP = OOM → partia 2. Mieszanka 3B: 48 i 24 procesy = OOM w scope 60G (zadanie ~2,2 GB RSS + bufor zapisu) → 16 proc., MemoryHigh 64G / MemoryMax 80G. Dedup: zapis strumieniowy zamiast list.

  5. tmux nie dziedziczy env; zsh nie dzieli $E

    Zmienne wprost w stringu komendy tmux. Czekacze (skrypty pętlące po logach przez ssh) pisać w bashu, nie zsh (źle dzielą wyjście ssh).

  6. pkill -f łapie własne ssh

    Wzorzec z nawiasem: pkill -f "[o]ut przebiegi/s3b", pgrep -f "[e]wal.py".

  7. Skrypt bez set -e wpisał fałszywe GOTOWE

    Po padzie treningu 8k znacznik sukcesu i tak się zapisał. Każdy krok krytyczny z || { echo BLAD; exit 1; }; bramki czytają znaczniki błędu.

  8. Przesył wag wolnym łączem ~0,6 MB/s

    Ewaluacja dwuetapowa (generacja na GPU tam, gdzie są wagi; ocena solverem tam, gdzie solver) zamiast przenosin plików.

  9. Kontaminacja testów

    PolEval bpb bazowy mógł być skażony; pierwsza bramka 3B pokazała 15% skażonych dokumentów PolEval → odkażanie 2. przejścia po plikach .bin, bramka (domena 0%, PolEval < 1%), raportowanie na czystym podzbiorze.

  10. DSpine do masowej generacji

    Max 8 równoległych żądań → do generacji danych bez dekodowania spekulatywnego (SGLang wprost). Czas w logach zawsze z date.

  11. Podmiana pliku danych w trakcie biegu

    Działający trening trzyma stary i-węzeł: podmieniać przez os.replace na nowy plik; przy wyżarzaniu z domeną konieczne zatrzymanie i wznowienie z checkpointu.

  12. Domyślny tokenizer na atari to stary 16k (11.11)

    Bez STAN_TOK=…/stanislaw_unigram32k_v3.model ewaluacja modelu 1B generuje bezsensowny tekst i pada na OUT_OF_RANGE: piece id. Próba „przeszła”, bo sprawdzany był kod wyjścia, nie treść. Dziś ewal_raft.py odmawia startu, gdy rozmiar słownika tokenizera nie zgadza się z modelem, a każdą próbę porównuje się z odpowiedziami znanymi z wcześniejszego biegu.

  13. SFT 1B na Tesli V100 32 GB

    Partia 2 × 1536 w fp16 = OOM w pierwszym kroku, gdy AdamW zaalokuje stany; działa partia 1 × akumulacja 24 na dwóch kartach (30,2 GB na kartę, ~10,8 tys. tok/s).

  14. Właściciel maszyny i dysk

    Karty 0, 1, 6, 7 zen5 bywały zajmowane ponownie przez właściciela; dysk roboczy w 93-96% (≈360-616 GB wolne w różnych momentach). Surowe pobrania skasowane po dedupie za zgodą; teksty branżowe (art. 26²) do usunięcia z zen5, gdy przestaną być potrzebne.

Miejsca oznaczone „do uzupełnienia”

Zebrane w jednym miejscu, żeby dało się je domknąć przy następnej sesji na maszynach (tylko odczyt).

  • Etap 1: wersje pakietów venv na zen5 (torch, CUDA) i sposób instalacji; brak pliku requirements.
  • Etap 2: argumenty pobierz_hf.sh użyte dla HQ-Plus, FinePDFs, FinePDFs-Edu; źródło i komenda pobrania HPLT 3.0 (biny 9-10); skrypt zbierający korpus domenowy (2340 art.); czasy pobierania.
  • Etap 3: czas trenowania tokenizera v3; krok kopiowania v2 do tokenizer/stanislaw.model.
  • Etap 5: dokładna komenda mieszanka_3b.py --odkaz i czasy budowy mieszanek 1B i 3B.
  • Etap 6: rozmiar checkpointu 1B z optymalizatorem (3B zmierzony: 36,5 GB).
  • Etap 7: liczba 97,5% w teście hasła podana z briefu; plik wyników nie był czytany.
  • Etap 8: komendy startu nauczycieli SGLang na zen5 (Qwen3.8-27B, Bielik) i tuneli; komendy, które wytworzyły odmowy_*, rall_*, r7_*; budowa solvera Rust (solver_cli, poza repo); czasy parafraz i RAFT.
  • Etap 9: czasy SFT6 i SFT8 (kroki znane, czas nie).
  • Etap 10: uprząż ewal.py / stanislaw_lm.py i YAML zadań polish_mc (zen5 /ewal, poza repo).